話題のAIツールを「導入しない」と決めるまで。並列AIコーディングツール評価の4つの軸
話題のAIツールを「導入しない」と決めるまで。並列AIコーディングツール評価の4つの軸
AIコーディングツールが毎週のように出てきます。GitHubで1,000スター超え、SNSのタイムラインにも流れてくる。技術選定を任されている人なら「うちも入れたほうがいいのでは」という空気を一度は感じたはずです。
導入記事はいくらでも見つかります。「入れたら速くなった」「生産性が上がった」。一方で、評価した結果あえて見送った、という記録はほとんど表に出てきません。採用は成果で語れますが、不採用は「何も変わらなかった」ようにしか見えないからです。
その不採用の根拠を残しておかないと、同じ並列AIコーディングツールを半年後にまた一から評価する羽目になります。この記事では、複数のAIコーディングCLIを並列実行するツール「dmux」を実際に評価して不採用にした過程と、そのとき使った4つの判断軸を共有します。話題のツールを「入れない」と決めるための材料として読んでください。
結論:流行ではなく業務実態とリスクに照らすと「不要」だった
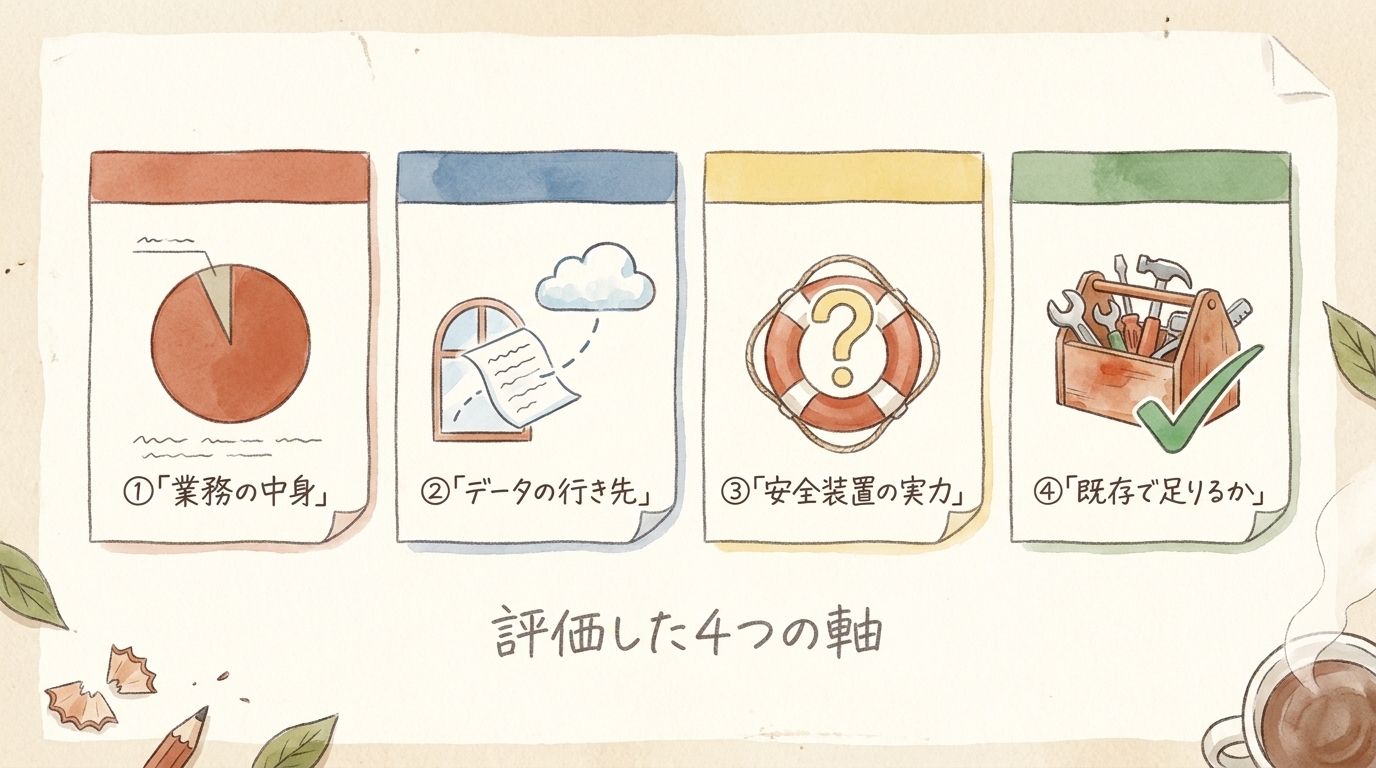
並列AIコーディングツールの評価で、最終的に全面導入はしないと判断しました。判断に使ったのは次の4軸です。ツールを評価するとき、この4点を見れば判定がぶれません。
# | 評価の軸 | 何を問うか |
|---|---|---|
1 | 適用範囲 | 自社業務の何割がそのツールの対象か |
2 | データ安全性 | 入力データが外部に送信される経路があるか |
3 | 既存代替手段 | 今の構成で同じことが既にできていないか |
4 | 独自価値の切り分け | そのツールにしかない価値は「機能」か「操作性」か |
この4軸で並列AIコーディングツール(dmux)を評価した結果はこうなりました。
- 並列でのコーディング作業を速くする効果はある。ただし業務に占めるコーディングの割合が低いと、運用コストを回収できない
- ブランチ名やコミットメッセージの自動生成で、git diff(=コードの変更差分)が外部のAIに送信される。機密データを扱うリポジトリでは流出リスクになる
- 既存のツール構成で、並列実行は十分にできていた
- 独自価値は「並列実行の能力」ではなく「複数画面を一望できる操作性」だった。今の業務量では割に合わない
スター数やバズではなく、この4軸に自社の数字を当てはめて判断する。それが今回の評価の骨子です。
入れた場合 vs 見送った場合:何が変わるか
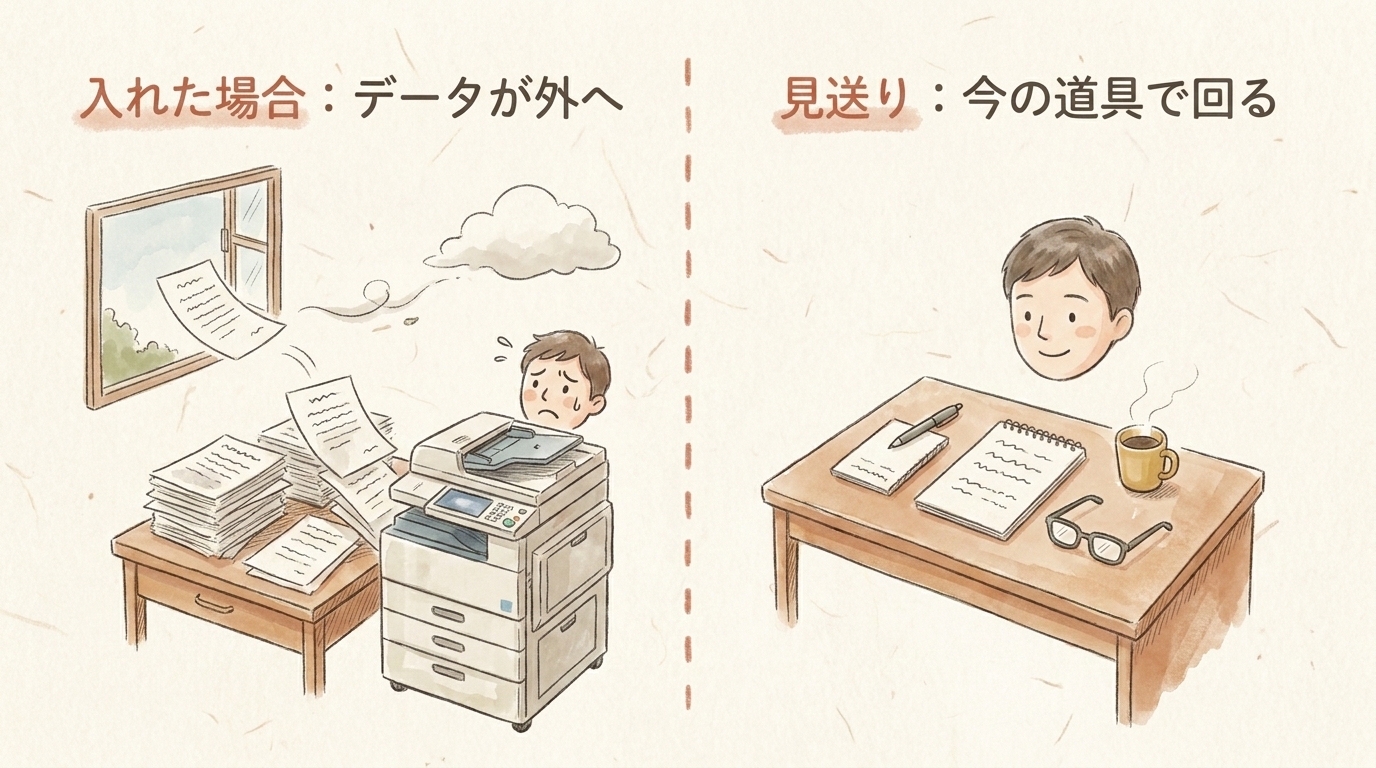
導入を迷っている人が一番知りたいのは「入れたら何が良くて、見送ると何を失うのか」でしょう。今回のケースを並べます。
並列AIコーディングツールを入れた場合 | 見送った場合(今回の判断) | |
|---|---|---|
コーディング速度 | 複数AIの並列実行で多少上がる余地 | 既存構成でも並列実行できており、差は小さい |
対象になる業務 | 全体の2割(コーディング)だけ | 残り8割は元から対象外で影響なし |
データの流れ | git diffが外部AIに送られる経路が増える | 送信経路が増えず、流出リスクが上がらない |
学習・運用の負担 | 新ツールの習熟とトラブル対応が発生 | 既存ツールの運用知識だけで回る |
安全装置 | 自動マージ機能はあるが品質保証ではない | 既存のCI・レビュー体制をそのまま使う |
「入れれば速くなる」のはコーディングの部分だけです。その部分が業務全体の2割しかなく、代わりにデータの送信経路と運用負担が増える。差し引きでマイナス、というのが今回の見立てでした。
評価した経緯:1,600スターのツールをなぜ見にいったか
ある案件で、1日に19本のプルリクエスト(=コード変更の取り込み依頼)を出す開発の山場がありました。複数のAIワーカーを並列に走らせ、別のAIでセカンドオピニオンを取り、各ブランチのマージを手作業で管理していた時期です。
そのタイミングでタイムラインに流れてきたのがdmuxでした。dmuxは、複数のAIコーディングCLI(12種に対応)を、それぞれ独立した作業フォルダとブランチで並列実行するツールです。MITライセンス、GitHubで1,600スター。AIがブランチ名とコミットメッセージを自動生成し、smart merge(=成果物を自動でまとめる機能)で統合する仕組みが入っていました。
19本のプルリクを並列でさばいていた最中だったので、「これを使えばもっと速くなるのでは」と評価を始めたわけです。注目度は高い。問題は、それが自社の業務に効くかどうかでした。
不採用の4つの理由
評価の結果、全面導入はしないと決めました。理由は4つあります。前述の4軸が、ここで具体的なNG判定につながります。
理由1:業務の8割はコーディングではない
並列AIコーディングツールが速くするのは、あくまでコーディング作業です。ところが実際の業務を振り返ると、記事の執筆、広告の運用と分析、データ基盤の保守、業務システムの設定、プロジェクト管理。こうした非コーディング作業が全体の8割を占めていました。
dmuxはこの8割には何も効きません。ツールの導入・学習・トラブル対応にかかる手間は、コーディングが2割しかない環境では回収できない計算になります。
ここで効くのが1つ目の軸「適用範囲」です。自分のチームの業務のうち、対象作業が何割を占めるか。これを先に測ってから導入を検討する。順序を逆にすると、効く範囲の狭いツールに学習コストを払うことになります。
理由2:git diffが外部のAIに送信される
dmuxのブランチ名生成とコミットメッセージ自動生成は、内部で外部のLLMゲートウェイを呼び出します。このときgit diffの中身が、AIへの指示文の一部として外部に送られます。
公開リポジトリや個人プロジェクトなら気にする必要はありません。医療データ・顧客情報・契約内容を含むリポジトリでは話が別です。git diffには変更前後のコードだけでなく、コメントに書かれた仕様や、テストに埋め込まれたサンプルデータも乗ってきます。
「機密リポジトリでは外部送信の鍵を渡さない」という運用で機能を止めれば回避はできます。ただしそれはdmuxの主要な便利機能を捨てるということです。機能を殺して使うツールを、わざわざ導入する理由はありません。2つ目の軸「データ安全性」で引っかかった形です。
理由3:smart mergeは安全装置ではない
dmuxには、複数のAIブランチの成果物を自動でまとめるsmart merge機能があります。便利ではあるものの、これはローカルでの衝突解消を自動化しているだけです。
本番コードの品質を守る仕組みは別にあります。マージ前の保護ルール、必須テストの通過、人間によるコードレビュー。これらはsmart mergeでは代替できません。自動でまとまったことと、本番に出していいことは別の話です。
既存の安全装置がすでに機能しているなら、smart mergeは「便利な自動化」であって「安全装置の追加」ではない。ここを取り違えると、品質チェックを省くきっかけになりかねません。
理由4:既存ツールで並列実行はできている
そもそもの動機は「並列実行を速くしたい」でした。ところが手元の環境を見直すと、既存のAIエージェント機能(独立した作業フォルダを自動で作る)と別AIのセカンドオピニオンの組み合わせで、並列実行はすでに回っていました。
機能 | 既存構成 | dmux |
|---|---|---|
独立フォルダでの並列実行 | AIエージェント(フォルダ分離) | tmux + 作業フォルダ |
セカンドオピニオン | 別AIモデルで検証 | 複数AIの画面 |
プルリク作成 | 標準コマンド | 標準コマンド(同じ) |
マージ | 手動 or CI | smart merge + 手動 |
差は「複数画面を一望できること」と「不要ブランチの自動掃除」くらいでした。並列実行の能力そのものは同じで、dmuxが上乗せするのは操縦席の使い心地だけ。3つ目の軸「既存代替手段」と4つ目「独自価値の切り分け」が、ここで同時に答えを出します。
その操縦席が効いてくるのは、3画面以上を常時監視する開発の山場が日常化したときです。今は週に1〜2日。導入の損益分岐点に届いていませんでした。
「もし使うなら」の条件
不採用にしたとはいえ、条件が変われば検討の余地はあります。今回の評価で見えた、採用する場合のガードレールを残しておきます。
- 使う範囲はプルリク作成までに限る。自動マージ機能は使わず、品質はCIと人間のレビューで担保する
- 機密リポジトリでは外部送信の鍵を渡さない。AI命名は使えなくなるが、データ流出を防ぐほうを優先する
- 導入するなら1リポジトリ限定のお試しから。全リポに一括投入せず、1〜2週間試して、画面管理の負担が本当にボトルネックかを確かめる
- 3並列以上を毎日回し、画面の切り替えが苦痛になった時点で再検討する。今ではなく「痛みが先に来てから」入れる
ツール評価チェックリスト:採用前に見る4点
今回の4軸は、並列AIコーディングツールに限らず、ほとんどのSaaS・業務ツールの評価に使えます。次のツール導入を判断するとき、このまま流用してください。
- [ ] 適用範囲:そのツールが対象とする作業は、自社業務の何割か(割合を実数で出す)
- [ ] データ安全性:入力したデータが外部に送信される経路はあるか。機密情報が乗る可能性はあるか
- [ ] 既存代替手段:今のツール構成で、同じ目的をすでに達成できていないか
- [ ] 独自価値の切り分け:そのツール固有の価値は「機能」か、それとも「操作性・見た目」か
- [ ] 損益分岐点:今の業務量で導入コストを回収できるか。回収できる「痛み」はいつ来るか
ツール選定をもう少し体系立てて進めたい場合は、安さ以外の軸まで含めた中小企業向けSaaS選定フレームワークも判断の下敷きになります。
アンチパターン:ツール導入判断でよくある失敗
アンチパターン1:スター数とバズで判断する
GitHubのスター数やSNSでの言及量は、ツールの注目度を表す数字であって、自社の業務への適合度を表す数字ではありません。注目度が高いほど導入圧力も上がりますが、効くかどうかは別問題です。先に測るのは「自社業務の何割に効くか」のほうです。
アンチパターン2:「入れてから考える」で評価を飛ばす
「とりあえず入れて、合わなければやめればいい」は個人利用なら通用します。チームの運用フローに組み込むツールでは事情が変わります。一度フローに入ると、外すのにもコストがかかる。だから評価は導入の前にやります。
アンチパターン3:リスクを「運用でカバー」する前提で入れる
「データの外部送信は機密リポで気をつければいい」という判断は、人間が毎回間違えないことを前提にしています。人間は忘れます。設定をうっかり1つ外せば、機密データが外に出る。構造的に防げないリスクは「運用で気をつける」ではなく「そのツールを入れない」で対処するほうが安全です。
まとめ:「入れない」判断も4軸で言語化できる
並列AIコーディングツールの評価で使った判断を整理します。
- 適用範囲。業務の何割が対象か。コーディングが2割なら、並列コーディングツールの効果は限定的になる
- データ安全性。git diffなど入力データが外部に送られる経路があるか。機密データを扱うなら致命的になりうる
- 既存代替手段。今の構成で同じことができていないか。能力が同じなら、操作性だけのために導入コストを払うかを問う
- 独自価値の切り分け。そのツール固有の価値は機能か操作性か。操作性なら、それが効く業務量に達しているか
流行のツールを「入れない」と決めるのは、入れる判断より勇気が要ります。それでもこの4軸で評価を残しておけば、半年後に同じツールを見たとき「前回なぜ見送ったか」が一目で分かる。判断のログそのものが、技術選定の資産になります。
AIツールの「入れる・入れない」を整理したい方へ
AIコーディングツールも業務SaaSも、選択肢は増え続けています。何を入れて何を見送るか、既存の構成とどう組み合わせるか。この線引きを最初に決めておくことが、流行に振り回されずに成果を出す分かれ目になります。「導入したいが判断軸がない」「セキュリティ面のリスクを誰も評価できていない」という状態は、よく社内で起きています。
f2t.jpでは、AI開発環境やツール選定の評価支援から、自社業務に合わせた設計までお手伝いしています。まずは「そのツールが自社業務の何割に効くか・外部にデータが出ないか・既存構成で足りていないか」を一緒に整理するところから始められます。お問い合わせフォームからご相談ください。
この記事のテーマに合うサービス:AIエージェント活用設計
AIエージェントを「使える形」まで設計する